在part2中讲到了学习算法,这部分讲一讲和此相关的一些算法和参数相关的设定问题。
神经网络的学习的目的是找到使损失函数的值尽可能小的参数。这是寻找最优参数的问题,解决这个问题的过程称为最优化 ( optimization )。遗憾的是,神经网络的最优化问题非常难。这是因为参数空间非常复杂,无法轻易找到最优解(无法使用那种通过解数学式一下子就求得最小值的方法)。而且,在深度神经网络中,参数的数量非常庞大,导致最优化问题更加复杂。
SGD
在part2中,为了找到最优参数,我们将参数的梯度(导数)作为了线索。使用参数的梯度,沿梯度方向更新参数,并重复这个步骤多次,从而逐渐靠近最优参数,这个过程称为随机梯度下降法 ( stochastic gradient descent ),简称SGD。
令需要更新的权重参数记为$W$,损失函数关于$W$的梯度记为$\frac{\partial L}{\partial W}$,$\eta$为学习率(一般取0.01或0.001这些事先决定好的值) 。用数学式可以将SGD的更新方式写为:
用python实现如下:1
2
3
4
5
6
7
8class SGD:
def __init__(self, lr=0.01):
self.lr = lr # 学习率
def update(self, params, grads):
for key in params.keys():
# 参数 params和 grads都是字典型变量,分别保存权重参数和梯度
params[key] -= self.lr * grads[key]
SGD是朝着梯度方向只前进一定距离的简单方法,在学习过程中,会不断的调用它。使用这个SGD类,可以按如下方式进行神经网络的参数的更新:1
2
3
4
5
6
7
8
9
10network = TwoLayerNet(...)
optimizer = SGD() # 进行参数优化的方法实体,参数的更新由 optimizer负责完成
for i in range(10000):
...
x_batch, t_batch = get_mini_batch(...) # mini-batch
grads = network.gradient(x_batch, t_batch)
params = network.params
optimizer.update(params, grads)
...
同理,之后的一些学习方法,只需要将optimizer替换为对应的方法实体即可。
SGD虽然实现简单,但是在解决某些问题时会低效,比如如下函数:
函数是向$x$轴方向延伸的“碗”状函数,等高线呈向$x$轴方向延伸的椭圆状: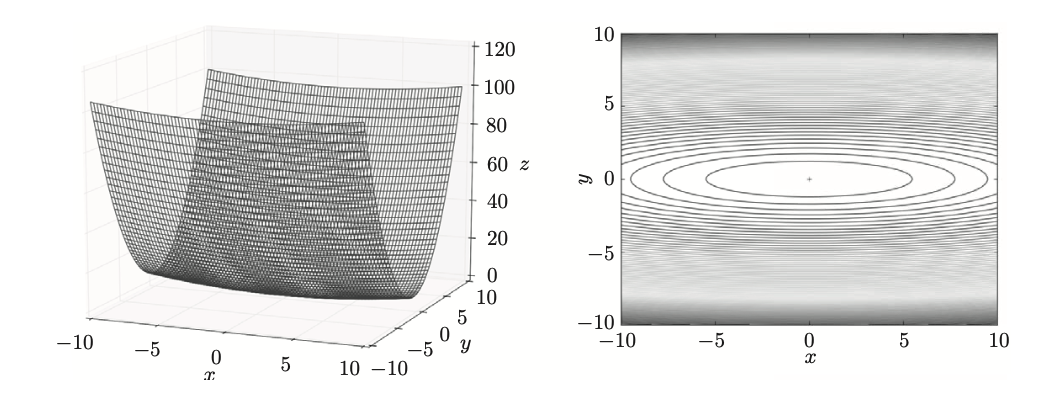
如果用图表示梯度的话,则如下图所示。这个梯度的特征是,$y$轴方向上大,$x$轴方向上小。换句话说,就是$y$轴方向的坡度大,而$x$轴方向的坡度小。这里需要注意的是,虽然上式最小值在$(x, y) = (0, 0)$处,但是图中的梯度在很多地方并没有指向$(0, 0)$。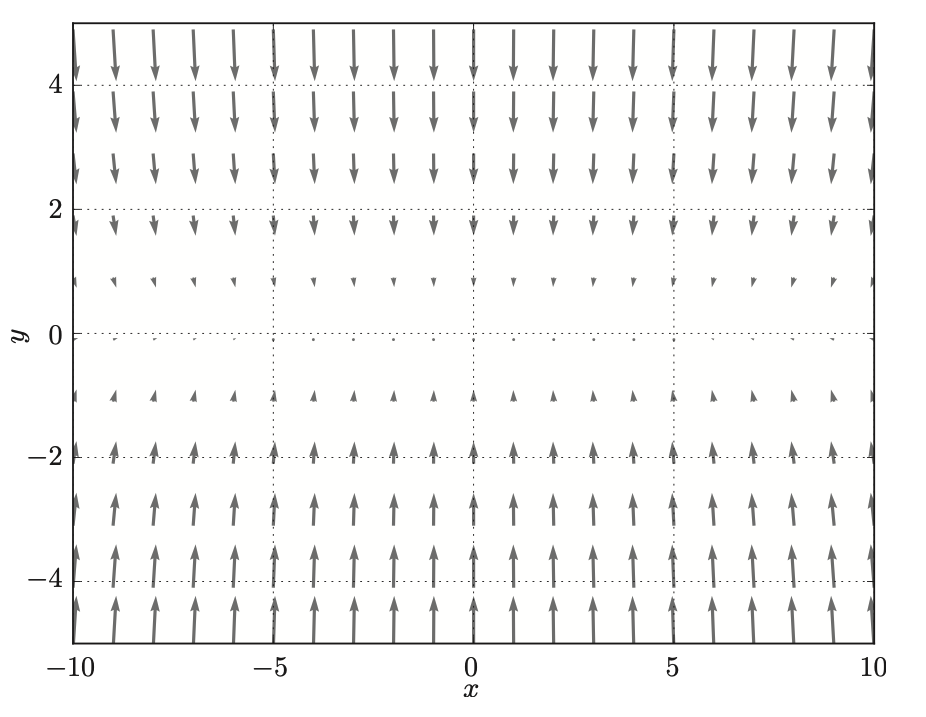
由于函数的形状非均向,梯度的方向并没有指向最小值的方向,SGD在搜索时会非常低效。搜索路径会呈“之”字型移动。如下图: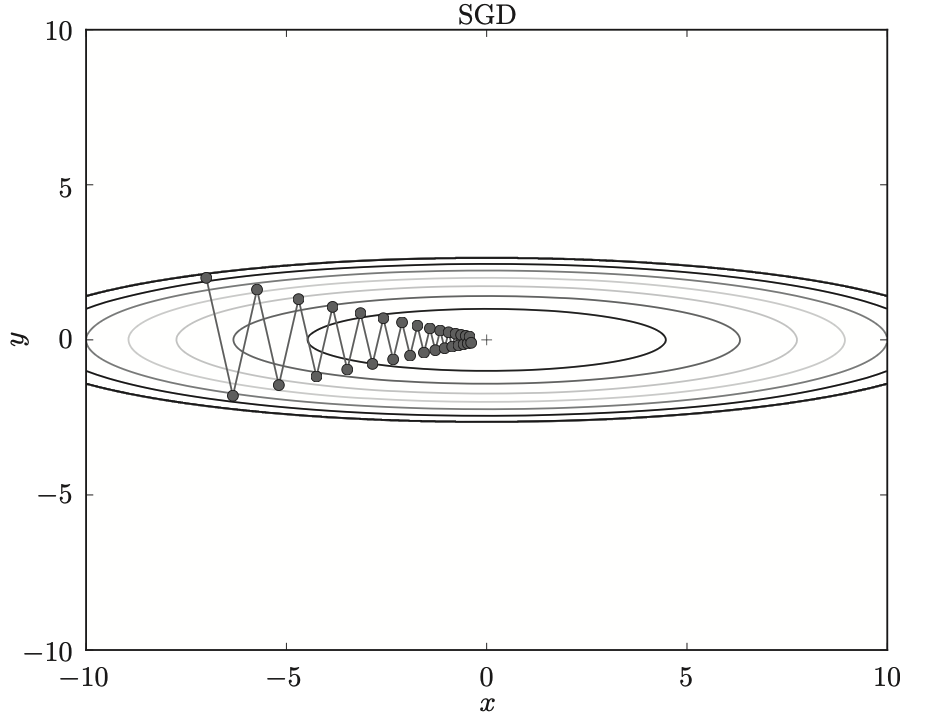
Momentum
Momentum是“动量”的意思,和物理有关。用数学式表示Momentum方法,令需要更新的权重参数记为$\mathit{W}$,损失函数关于$\mathit{W}$的梯度记为$\frac{\partial L}{\partial \mathit{W}}$,$\eta$为学习率,$\mathit{v}$代表物理上的速度如下所示。
上式表示了物体在梯度方向上受力,在这个力的作用下,物体的速度增加这一物理法则。如图所示,Momentum方法给人的感觉就像是小球在地面上滚动。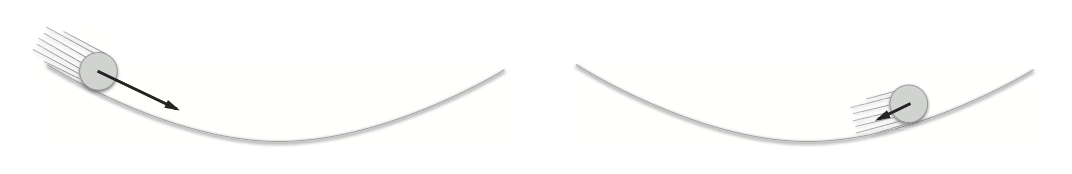
式中有 $\alpha v$ 这一项。在物体不受任何力时,该项承担使物体逐渐减速的任务($\alpha$设定为0.9之类的值),对应物理上的地面摩擦或空气阻力。
python实现如下:1
2
3
4
5
6
7
8
9
10
11
12
13
14CLass Momentum:
def __init__(self, lr=0.01, momentum=0.9):
self.lr = lr
self.momentum = momentum
self.v = None
def update(self, params, grads):
if self.v is None:
self.v = {}
for key,val in params.items():
self.v[key] = np.zeros_Like(val)
for key in params.keys():
self.v[key] = self.momentum * self.v[key] - self.lr * grads[key]
params[key] += self.v[key]
更新路径如下图。和SGD相比,我们发现“之”字形的“程度”减轻了。这是因为虽然$x$轴方向上受到的力非常小,但是一直在同一方向上受力,所以朝同一个方向会有一定的加速。反过来,虽然$y$轴方向上受到的力很大,但是因为交互地受到正方向和反方向的力,它们会互相抵消,所以$y$轴方向上的速度不稳定。因此,和SGD时的情形相比,可以更快地朝$x$轴方向靠近,减弱“之”字形的变动程度。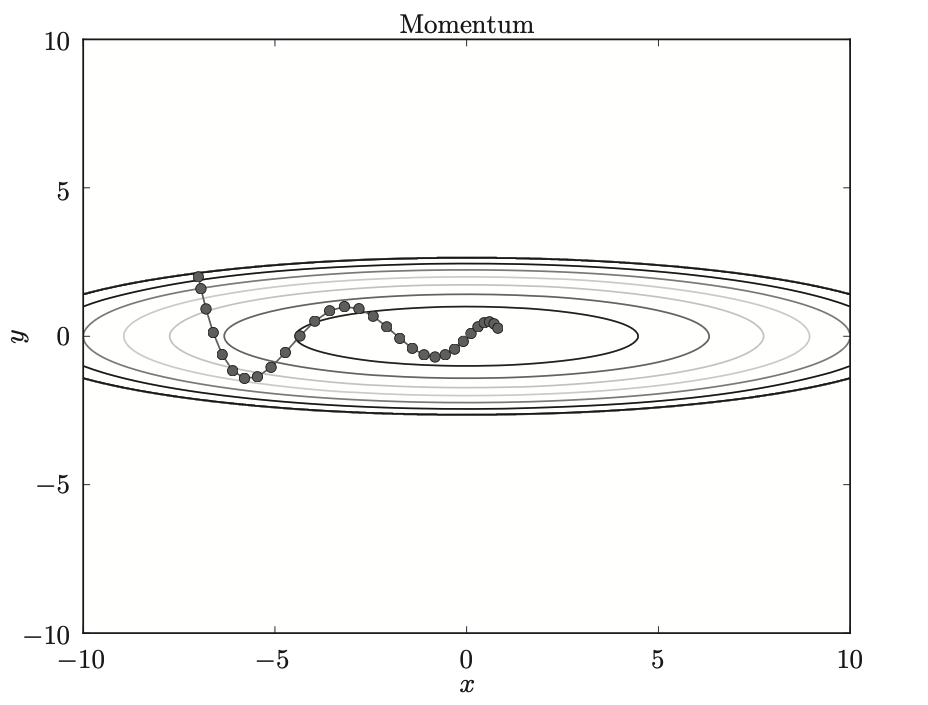
AdaGrad
AdaGrad会为参数的每个元素适当地调整学习率,与此同时进行学习。用数学式表示AdaGrad的更新方法,令需要更新的权重参数记为$\mathit{W}$,损失函数关于$\mathit{W}$的梯度记为$\frac{\partial L}{\partial \mathit{W}}$,$\eta$为学习率,$h$保存了以前的所有梯度值的平方和。
在更新参数时,通过乘以$\frac{1}{\sqrt{\mathit{h}}}$,就可以调整学习的尺度。这意味着,参数的元素中变动较大(被大幅更新)的元素的学习率将变小。也就是说,可以按参数的元素进行学习率衰减,使变动大的参数的学习率逐渐减小。(AdaGrad 会记录过去所有梯度的平方和。因此,学习越深入,更新的幅度就越小。实际上,如果无止境地学习,更新量就会变为 0,完全不再更新)
python实现如下:1
2
3
4
5
6
7
8
9
10
11
12class AdaGrad:
def __init__(self, lr=0.01):
self.lr = lr
self.h = None
def update(self, params, grads):
if self.h is None:
self.h = {}
for key, val in params.items():
self.h[key] = np.zero_like(val)
for key in params.keys():
self.h[key] += grads[key] * grads[key]
params[key] -= self.lr * grads[key] / (np.sqrt(self.h[key]) + 1e-7)
最后一行加上了微小值 1e-7。这是为了防止当self.h[key]中有$0$时,将$0$用作除数的情况。在很多深度学习的框架中,这个微小值也可以设定为参数,但这里我们用的是1e-7这个固定值。
由图结果可知,函数的取值高效地向着最小值移动。由于$y$轴方向上的梯度较大,因此刚开始变动较大,但是后面会根据这个较大的变动按比例进行调整,减小更新的步伐。因此,$y$轴方向上的更新程度被减弱,“之”字形的变动程度有所衰减。
权重的初始值
除了最优化方法之外,神经网络的学习还涉及权重初始值的设定、Batch Normalization、抑制过拟合的正则化、超参数的最优化等诸多技巧,下面逐一进行说明。首先来思考权重的初始值应该如何设定。
神经网络的权重初始值的设定非常重要,甚至经常关系到神经网络的学习能否成功。首先,能不能把权重初始值全部设为0呢?答案是否定的。如果权重全部设为相同的值(比如全为0),那么在正向传播时,同一层的所有神经元都会计算出完全相同的值;而在反向传播时,它们的梯度也完全相同。这样一来,无论这一层有多少个神经元,它们学到的东西都一模一样,相当于只有一个神经元在起作用,神经网络也就失去了它本来的表现力。因此,必须随机地设定权重初始值,使各个神经元能够学习到不同的特征。
但是,随机初始化的“尺度”(标准差)也不能随意设定。如果权重尺度过大或过小,各层激活值的分布就会发生偏斜,从而引发梯度消失或者表现力受限等问题。为了解决这一问题,常用的有Xavier初始值和He初始值。
Xavier初始值也被称为Xavier/Glorot初始值,其设定方法是:如果前一层的节点数为$n$,则权重使用标准差为$\frac{1}{\sqrt{n}}$的高斯分布:
Xavier初始值适合sigmoid函数和tanh函数等左右对称的S形曲线激活函数。它的目标是让各层的激活值拥有适度的广度,从而抑制梯度的消失和放大(关于这一点,后面会通过实验进行确认)。
He初始值是专门为ReLU函数设计的初始值,其设定方法是:如果前一层的节点数为$n$,则权重使用标准差为$\sqrt{\frac{2}{n}}$的高斯分布:
He初始值比Xavier初始值的尺度更大。这是因为ReLU函数在负半轴的输出恒为0,相当于每层都有一半左右的神经元被“关闭”了,为了让信号(方差)在层与层之间传递时不衰减,需要将标准差扩大$\sqrt{2}$倍。
总结一下:激活函数是sigmoid或tanh时使用Xavier初始值,激活函数是ReLU时使用He初始值。现在的深度学习框架中,默认(或推荐)对ReLU使用He初始值。
隐藏层的激活值的分布
观察隐藏层的激活值的分布,是判断权重初始值是否合适的一个方便的方法。这里做一个简单的实验:向一个5层(每层100个神经元)的神经网络输入随机产生的1000个数据(数据为高斯分布的100维数据),观察每一层的激活值的分布。
首先是权重初始值为标准差是1的高斯分布时的实验。用图表示这个实验的结果(激活函数使用sigmoid函数):
1 | input_data = np.random.randn(1000, 100) # 1000个数据 |

各层的激活值呈现出偏向0和1的分布。这里使用的激活函数是sigmoid函数,而sigmoid函数在输出靠近0或靠近1的地方它的导数都接近于0。因此,偏向0和1的分布会造成反向传播中梯度的值不断变小,最后消失。这个问题称为梯度消失(gradient vanishing)。层次加深的深度学习中,梯度消失的问题可能会更加严重。
接着是权重初始值为标准差是0.01的高斯分布时的实验。结果如图:

这次呈现在0.5附近集中的分布。这样虽然不会发生梯度消失的问题,但是激活值的分布有所偏向,说明表现力方面有问题。因为如果有多个神经元都输出几乎相同的值,那它们就没有存在的意义了。打个比方,100个神经元都输出几乎相同的值,那么也可以由1个神经元来表达基本相同的信息。因此,激活值在分布上有所偏向会出现“表现力受限”的问题。
那么,怎样设定权重初始值才合适呢?Xavier初始值是一个常用的方法。它的设定方法是:如果前一层的节点数为$n$,则初始值使用标准差为$\frac{1}{\sqrt{n}}$的分布。使用Xavier初始值后的结果如图:

从图中可知,各层的激活值呈现出具有广度的分布。因为各层间传递的是有变化的数据(表现为分布广度变大),所以sigmoid的表现力不受限制,学习的效率更高。因此,使用sigmoid或tanh等S型曲线激活函数时,Xavier初始值是一个合适的选择。
接着来看激活函数使用ReLU函数的情况。首先是权重初始值为标准差是0.01的高斯分布时的实验,结果如图:

从图中可知,随着层的加深,激活值很快就集中到了0附近。这种情况下,可以认为神经元没有被有效利用,网络几乎没有在传递信息。接着是使用Xavier初始值时的实验,结果如图:

从图中可知,随着层的加深,激活值的广度逐渐变窄。虽然不像std=0.01时那样夸张,但层级越深,数据的偏向性越大,因此使用ReLU函数时,Xavier初始值并不算是一个好的选择。
ReLU函数专用的是He初始值。它的设定方法是:如果前一层的节点数为$n$,则初始值使用标准差为$\sqrt{\frac{2}{n}}$的高斯分布。使用He初始值后的结果如图:

从图中可知,即使层级加深,各层中激活值的广度依然保持相同。因此,使用ReLU函数时,He初始值是一个合适的选择。
Batch Normalization
虽然合理设定权重初始值可以避免激活值的分布发生偏斜,但是还有更加直接的方法来控制激活值的分布,这就是Batch Normalization(批归一化)。
Batch Normalization(以后简称Batch Norm)是2015年提出的方法。Batch Norm虽然是一个实现上比较简单的技巧,但在很多深度学习框架中被作为标准功能提供。Batch Norm有以下优点:
- 可以使学习快速进行(可以增大学习率)。
- 不那么依赖初始值(对于初始值不那么敏感)。
- 抑制过拟合(降低Dropout等的必要性)。
Batch Norm的思路是调整各层激活值的分布,使其拥有适当的广度。为此,要向神经网络中插入对数据分布进行正规化的层,即Batch Normalization层(下文简称Batch Norm层)。
Batch Norm,顾名思义,以进行学习时的mini-batch为单位,按mini-batch进行正规化。具体而言,就是进行使数据分布的均值为0、方差为1的正规化。用数学式表示如下:
这里假设mini-batch由$m$个数据组成,$\mu_B$是这个mini-batch的均值,$\sigma_B^2$是方差。对输入数据$x_i$减去均值$\mu_B$再除以标准差$\sqrt{\sigma_B^2+\varepsilon}$,就得到均值为0、方差为1的数据$\hat{x}_i$。$\varepsilon$是一个微小值(比如$10^{-7}$),防止除以0的情况发生。
通过对输入数据的正规化,将其变为均值为0、方差为1的数据$\hat{x}$后,Batch Norm层还会对正规化的数据进行缩放和平移的变换:
其中,$\gamma$和$\beta$是可学习的参数,$\gamma$为缩放因子,$\beta$为平移量。这两个参数的初始值分别设为1和0,然后在训练中通过学习进行调整。
Batch Norm层应该插入在哪里呢?具体而言,可以插入到Affine层和ReLU(激活函数)层之间,如下图所示:

这样,神经网络可以在保持数据分布广度的同时进行学习。此外,Batch Norm在推理时使用的是训练时计算得到的移动平均(moving average),而不是推理时mini-batch的统计量。这样一来,无论每个mini-batch的大小如何,推理都可以得到稳定的结果。
用python实现如下(这里实现forward和backward):1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78class BatchNormalization:
def __init__(self, gamma, beta, momentum=0.9, running_mean=None, running_var=None):
self.gamma = gamma
self.beta = beta
self.momentum = momentum
self.input_shape = None
self.running_mean = running_mean
self.running_var = running_var
self.batch_size = None
self.xc = None
self.xn = None
self.std = None
self.dgamma = None
self.dbeta = None
def forward(self, x, train_flg=True):
self.input_shape = x.shape
if x.ndim != 2:
N, C, H, W = x.shape
x = x.reshape(N, -1)
out = self.__forward(x, train_flg)
return out.reshape(*self.input_shape)
def __forward(self, x, train_flg):
if self.running_mean is None:
N, D = x.shape
self.running_mean = np.zeros(D)
self.running_var = np.zeros(D)
if train_flg:
mu = x.mean(axis=0)
xc = x - mu
var = np.mean(xc**2, axis=0)
std = np.sqrt(var + 1e-7)
xn = xc / std
self.batch_size = x.shape[0]
self.xc = xc
self.xn = xn
self.std = std
self.running_mean = self.momentum * self.running_mean + (1-self.momentum) * mu
self.running_var = self.momentum * self.running_var + (1-self.momentum) * var
else:
xc = x - self.running_mean
xn = xc / np.sqrt(self.running_var + 1e-7)
out = self.gamma * xn + self.beta
return out
def backward(self, dout):
if dout.ndim != 2:
N, C, H, W = dout.shape
dout = dout.reshape(N, -1)
dx = self.__backward(dout)
dx = dx.reshape(*self.input_shape)
return dx
def __backward(self, dout):
dbeta = dout.sum(axis=0)
dgamma = np.sum(self.xn * dout, axis=0)
dxn = self.gamma * dout
dxc = dxn / self.std
dstd = -np.sum((dxn * self.xc) / (self.std * self.std), axis=0)
dvar = 0.5 * dstd / self.std
dxc += (2.0 / self.batch_size) * self.xc * dvar
dmu = np.sum(dxc, axis=0)
dx = dxc - dmu / self.batch_size
self.dgamma = dgamma
self.dbeta = dbeta
return dx
过拟合
过拟合指的是拟合训练数据的能力过强,只对训练数据有效,而对测试数据(未学习过的数据)无法给出正确结果的神经网络。深度学习中经常出现过拟合的问题。
发生过拟合的原因,主要有以下两个:
- 模型拥有大量参数、表现力强。
- 训练数据少。
比如,只用300个MNIST训练数据,使用一个7层深度网络进行学习,随着学习的进行,对训练数据的识别精度很快达到了100%,但对测试数据的识别精度却停滞在75%左右。对训练数据是100%的识别精度,但测试数据上却只有75%,这就是典型的过拟合。
抑制过拟合的方法有很多种,下面介绍其中最有代表性的两种:权值衰减和Dropout。
权值衰减
权值衰减是一直以来被经常使用的一种抑制过拟合的方法。该方法通过在学习的过程中对大的权重进行惩罚,来抑制过拟合。很多过拟合正是因为权重参数取值过大才发生的。
权值衰减最常使用的是L2范数。L2范数相当于各个元素的平方和,用数学式表示如下:
其中,$\lambda$是控制正则化强度的超参数,$\lambda$设置得越大,对大的权重施加的惩罚就越重。$\frac{1}{2}$是用于将求导结果变成$\lambda\mathit{W}$的调整常数。
在计算损失函数时,将上式的L2范数加到损失函数上。这样一来,就能抑制权重变大。对神经网络的损失函数加上权值衰减后,求梯度时,要在梯度上加上正则化项的导数$\lambda\mathit{W}$:
因此,在使用SGD更新权重时,权重会先乘上小于1的常数再进行更新(比如学习率为0.1、$\lambda$为0.1时,每次更新时权重会先变成原来的0.99倍),这就是“权值衰减”这个名字的由来。
用MNIST的300个训练数据进行实验,结果如图:

图中实线是训练数据的识别精度,虚线是测试数据的识别精度。从图中可知,虽然训练数据和测试数据之间仍存在差距,但是与没有使用权值衰减时相比,差距变小了,过拟合受到了抑制。此外,训练数据的识别精度也没有达到100%,说明学习不再只拟合训练数据了。
Dropout
如果网络的模型复杂,光靠权值衰减就有些力不从心了。这种情况下,经常会使用Dropout方法。
Dropout是一种在学习的过程中随机删除神经元的方法。训练时,随机选出隐藏层的神经元,然后将其删除。被删除的神经元不再进行信号的传递,如下图所示:

训练时,每传递一次数据,就会随机选择要删除的神经元。然后,测试时,虽然会传递所有的神经元信号,但是对于各个神经元的输出,要乘上训练时的删除比例后再输出。测试时乘上删除比例是为了调整训练时被删除的神经元和没有被删除的神经元的输出的尺度(现在的深度学习框架中,大多采用训练时进行缩放的Inverted Dropout方式)。
用python实现如下:1
2
3
4
5
6
7
8
9
10
11
12
13
14class Dropout:
def __init__(self, dropout_ratio=0.5):
self.dropout_ratio = dropout_ratio
self.mask = None
def forward(self, x, train_flg=True):
if train_flg:
self.mask = np.random.rand(*x.shape) > self.dropout_ratio
return x * self.mask
else:
return x * (1.0 - self.dropout_ratio)
def backward(self, dout):
return dout * self.mask
每次正向传播时,self.mask中都会以False的形式保存要删除的神经元。self.mask会随机生成和x形状相同的数组,并将比dropout_ratio大的元素设为True。反向传播时的行为和ReLU的实现相同,即,通过正向传播时的信号是否被传递来决定反向传播时信号是否要传递。
可以这样理解Dropout的效果:训练时每次都会随机选择要删除的神经元,因此每次训练时都在训练一个不同的模型。而测试时传递所有神经元的信号,并对每个神经元的输出进行缩放,这可以看作是对训练时训练出的多个模型取了平均。因此,Dropout可以起到类似ensemble(集成学习)的效果,即通过训练多个模型并对结果取平均,来抑制过拟合。
需要注意的是,Dropout一般用于神经网络的隐藏层,删除比例(dropout_ratio)一般设为0.5。此外,Batch Norm、权值衰减和Dropout这些方法也可以组合使用。
超参数的最优化
神经网络中,除了权重和偏置等参数之外,还存在很多超参数(hyperparameter)。比如,各层中神经元的数量、batch size、学习率(或学习率衰减系数)、权值衰减系数、Dropout的删除比例等。和权重参数不同,超参数的设定很大程度上依赖于人的经验和直觉,寻找合适的超参数是一项非常费时的工作。
这里需要注意的是,调整超参数时,不能使用测试数据来评估超参数的好坏。如果使用测试数据调整超参数,那么超参数的值就会对测试数据发生过拟合,导致测试数据无法再作为衡量模型泛化能力的指标。因此,调整超参数时,必须使用专门用于评估超参数的数据,这种数据称为验证数据(validation data)。
比如,MNIST数据集有60000个训练数据,可以将其中的54000个作为训练数据,剩下的6000个作为验证数据,用于评估超参数的好坏。这里根据用途将数据分成了三类,也可以根据实际情况采用其他分割方式。但是,测试数据只能用于最后评估模型的泛化能力,不能用于调整超参数。
超参数的优化方法和神经网络参数的学习方法一样,需要在尝试多个值后,寻找一个使学习顺利进行的设定。但是,超参数的搜索空间非常大,如果盲目地逐一尝试,需要花费大量的时间。因此,实践中经常采用下面的步骤:
- 设定超参数的大致范围(以10的阶为尺度,即对数尺度)。
- 从设定的范围内随机采样,进行短时间的学习(比如1个epoch左右),观察验证数据的识别精度。
- 根据验证数据的识别精度,缩小超参数的范围。
- 重复上述步骤,逐渐缩小范围,最后在缩小的范围内进行详细搜索。
比如,对学习率和权值衰减系数进行随机采样时,可以像下面这样在对数尺度上进行采样:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15optimization_trial = 100
results_val = {}
results_train = {}
for _ in range(optimization_trial):
# 指定搜索的超参数的范围===============
weight_decay = 10 ** np.random.uniform(-8, -4)
lr = 10 ** np.random.uniform(-6, -2)
# ================================================
# 用采样的超参数进行学习,观察验证数据的识别精度
val_acc_list, train_acc_list = __train(lr, weight_decay)
key = "lr:" + str(lr) + " weight_decay:" + str(weight_decay)
results_val[key] = val_acc_list
results_train[key] = train_acc_list
这里对权值衰减系数在$10^{-8}$到$10^{-4}$之间、学习率在$10^{-6}$到$10^{-2}$之间的对数尺度范围内进行了随机采样。超参数的范围一开始可以设定得大一些,然后根据结果逐渐缩小。如下图所示,随着学习的推进,逐渐锁定“可能存在好值”的范围:
像这样,先在宽泛的范围内进行粗略搜索,然后在缩小的范围内进行详细搜索,可以高效地找到合适的超参数。需要注意的是,超参数的最优化非常耗时,因此每次实验的学习时间要短一些。此外,随机采样的效果一般比网格搜索(等间隔地逐一尝试)更好,因为随机采样可以更广泛地探索超参数空间。
更先进的超参数最优化方法中,有一种称为贝叶斯最优化的方法。它基于贝叶斯定理,根据之前实验的结果,推断出可能存在好值的区域,并决定下一次搜索的位置,从而更高效地搜索超参数。虽然贝叶斯最优化的实现比较复杂,但像Optuna、Hyperopt这样的库已经实现了这种方法,实践中可以直接使用。